Non voglio un’AI che mi scriva allenamenti. Voglio un’AI che capisca come mi sto allenando

Dal semplice generatore di schede a un coach digitale che utilizza storico, dati reali e contesto prima di suggerire cosa fare

Dopo aver costruito AI-nuoto e averlo collegato ai miei allenamenti reali attraverso Strava, mi sono posto una domanda.

Che cosa ho costruito realmente?

  • Un sistema capace di generare allenamenti?
  • Sì, ma questa è probabilmente la parte meno interessante.
  • Oggi posso aprire qualsiasi AI generativa e scrivere:
  • “Preparami un allenamento di nuoto da 3.000 metri per migliorare la capacità aerobica.”

In pochi secondi otterrò una scheda apparentemente credibile.

Ma quella scheda potrebbe essere adatta a me, a un altro nuotatore o praticamente a chiunque.

Il problema non è quindi generare un allenamento, il problema è generare l’allenamento giusto in quel momento.

Prima di decidere bisogna conoscere!

Un allenatore, prima di assegnare una seduta, dispone di informazioni.

Conosce l’atleta, sa cosa ha fatto nei giorni precedenti, conosce gli obiettivi e sa se si sta avvicinando una gara.

Un LLM utilizzato senza contesto non possiede nulla di tutto questo.

È qui che il progetto AI-nuoto ha iniziato ad assumere per me un significato differente.

Il sistema dispone ora di tre elementi.

  1. La storia: più di 200 allenamenti provenienti da Final Surge costituiscono la sua Knowledge.
  2. L’atleta: un profilo contiene riferimenti prestativi, CSS, obiettivi e caratteristiche dell’allenamento.
  3. La realtà: attraverso Strava può verificare gli allenamenti effettivamente eseguiti.

A questo punto la domanda può cambiare completamente.

Non più: “Fammi 3.000 metri.”

Ma: “Considerando quello che avrei dovuto fare, quello che ho realmente fatto e la mia progressione recente, cosa avrebbe senso fare domani?”

Questa è la domanda che mi interessa !

Planned e Completed raccontano due storie diverse

Durante la costruzione di AI-nuoto è emerso un concetto apparentemente banale ma fondamentale:

PLANNED ≠ COMPLETED

Il programma racconta ciò che avrebbe dovuto succedere, il dispositivo racconta ciò che è successo realmente.

Se Final Surge prevede 3.000 metri ma su Strava non esiste alcuna attività, AI-nuoto non deve concludere che io abbia nuotato 3.000 metri.

Se erano previsti 2.800 metri e Garmin ne registra 3.200, anche questa differenza è informazione.

E se negli ultimi giorni ho accumulato più volume del previsto, la seduta successiva potrebbe meritare una valutazione diversa.

È qui che il dato smette di essere semplicemente un numero.

Diventa contesto.

Dal dato alla decisione

L’architettura che si è creata può essere riassunta in quattro parole:

DATA → KNOWLEDGE → CONTEXT → DECISION

  • Data è il dato grezzo: metri, durata, frequenza cardiaca, data dell’attività.
  • Knowledge è la storia: allenamenti, struttura delle sedute, progressioni, esercizi.
  • Context è la situazione attuale: cosa ho fatto recentemente, quale obiettivo sto perseguendo, quanto manca alla prossima gara.
  • Decision è ciò che viene dopo.

Ed è proprio quest’ultimo passaggio quello più delicato.

Perché un’AI può avere accesso a migliaia di dati senza necessariamente prendere una buona decisione.

La qualità non dipende soltanto dalla quantità di informazioni disponibili, ma dalla capacità di metterle in relazione.

Un esempio concreto

Immaginiamo che nel calendario sia prevista una Seduta A da 3.000 metri; AI-nuoto potrebbe limitarsi a recuperarla dalla Knowledge, ma ora può fare qualcosa in più.

  • Può verificare su Strava se l’allenamento precedente è stato realmente effettuato.
  • Può confrontare distanza programmata e distanza eseguita.
  • Può guardare la progressione delle ultime Sedute A.
  • Può considerare i miei riferimenti prestativi.

E solo successivamente proporre una nuova seduta.

Il risultato finale può essere ancora un banalissimo:

Seduta A – 3.000 m

Ma ciò che cambia completamente è il processo che ha portato a quei 3.000 metri.

Ed è proprio questo che distingue, secondo me, un generatore da un agente.

Il ruolo dell’essere umano non scompare

C’è però un punto sul quale non vorrei creare equivoci.

Non penso che un progetto del genere elimini il ruolo dell’allenatore.

Al contrario, un coach vede cose che i dati spesso non raccontano.

Può osservare la tecnica, conoscere lo stato mentale dell’atleta, capire quando una giornata semplicemente non gira.

Anche il più sofisticato sistema di raccolta dati può sapere che ho completato 3.000 metri.

Non necessariamente sa come mi sono sentito mentre li facevo.

Ed ecco un altro pezzo interessante del progetto.

Il dato quantitativo deve incontrare quello qualitativo.

Dopo un allenamento potrei semplicemente dire ad AI-nuoto:

“Allenamento completato. Buone sensazioni fino ai 2.000 metri, poi ho iniziato a perdere qualità nella presa. Fatica 7/10.”

Poche parole.

Ma quelle poche parole possono dare un significato completamente diverso ai numeri registrati dall’orologio.

Il prossimo livello (capire cosa succede dentro l’allenamento)

Per ora ho volutamente mantenuto l’integrazione semplice; AI-nuoto recupera le attività da Strava e può confrontare programmato ed eseguito.

Ma esiste un livello successivo.

Gli stream permettono di analizzare l’andamento dei dati durante l’attività: tempo, distanza, frequenza cardiaca e altre informazioni disponibili.

A quel punto le domande potrebbero diventare:

  • La frequenza cardiaca è rimasta stabile?
  • Quando è iniziato il calo?
  • L’ultima parte è stata più impegnativa della prima?

Nel nuoto esiste però un’ulteriore difficoltà: Garmin possiede informazioni molto specifiche — vasche, bracciate, SWOLF, ripetute — che non necessariamente vengono esposte integralmente attraverso Strava.

Probabilmente sarà una delle prossime cose da esplorare.

Del resto sono un nerd in ferie 🙂

Qualcosa dovrò pur fare.

Un piccolo Digital Twin sportivo?

Spingendo un po’ più avanti il ragionamento, quello che sto costruendo assomiglia vagamente a un piccolo Digital Twin dell’atleta.

Non nel significato industriale rigoroso del termine, naturalmente.

Ma il concetto è interessante.

Esiste una rappresentazione digitale che conosce parte della mia storia sportiva, alcuni parametri prestativi, gli allenamenti programmati e quelli realmente eseguiti.

E questa rappresentazione viene aggiornata progressivamente.

Ogni nuovo allenamento aggiunge informazione, ogni nuovo test modifica i riferimenti, ogni gara aggiunge un nuovo punto alla storia.

L’AI non deve quindi “ricominciare da zero” ogni volta che le faccio una domanda. Ha una memoria sulla quale ragionare.

Ed è qui che l’AI diventa interessante

La cosa che più mi affascina di questo piccolo progetto non riguarda, in realtà, il nuoto.

Riguarda il modo in cui utilizzeremo l’intelligenza artificiale.

La prima fase dell’AI generativa è stata dominata dal prompt:

io chiedo → AI risponde.

La fase successiva potrebbe essere molto più interessante:

io chiedo → AI recupera il contesto → consulta i dati → utilizza la memoria → ragiona → risponde.

Il valore si sposta dal semplice modello alla combinazione tra modello, dati e contesto.

Nel mio caso tutto questo serve a decidere se domani devo fare 2.800 o 3.000 metri.

Non cambierò il mondo.

Ma probabilmente entrerò in piscina con un allenamento un po’ più ragionato.

E, per un appassionato di nuoto in acque libere e tecnologia, è già un ottimo risultato.

Quando l’AI incontra i dati reali: da Garmin e Strava al mio coach AI

A questo punto AI-nuoto sapeva perfettamente cosa era stato programmato.

Ma non necessariamente cosa avevo fatto, ed è una differenza enorme.

Final Surge può dirmi che il 6 agosto erano previsti determinati metri e determinati lavori.

Ma se quel giorno ho nuotato 3.500 metri, oppure ne ho fatti 2.000, oppure non sono proprio entrato in acqua, un coach intelligente dovrebbe saperlo.

Nasce così una distinzione fondamentale del progetto:

PLANNED ≠ COMPLETED

Non volevo che AI-nuoto vedesse un allenamento nel calendario e concludesse automaticamente che fosse stato eseguito.

Serviva quindi un’altra fonte dati, ed entra in gioco Strava.

Il Garmin registra praticamente ogni mio allenamento.

La strada ideale sarebbe quindi:

Garmin → AI

ma l’accesso diretto ai dati Garmin tramite le API ufficiali non è la soluzione più semplice per un piccolo progetto personale.

Fortunatamente nel mio ecosistema esiste già un ottimo ponte, Strava !!!

Garmin Connect sincronizza automaticamente le attività con Strava. Strava dispone inoltre di API che permettono, previa autorizzazione OAuth, di interrogare le attività dell’atleta.

A questo punto il nerd ha definitivamente preso il sopravvento sul vacanziere.

Ho creato una piccola applicazione Strava chiamata, naturalmente, AI-nuoto.

Poi ho configurato una Action nel mio GPT utilizzando OAuth e le API Strava, inizialmente esclusivamente in lettura (Nessuna possibilità di modificare o pubblicare attività).

Solo leggere ciò che serve al coach

Le prime operazioni sono volutamente semplici:

  • getAuthenticatedAthlete
  • getRecentActivities
  • getActivityDetails

Dopo qualche passaggio tra Client ID, Client Secret, callback URL e OAuth, è arrivato il momento del test.

AI-nuoto ha interrogato e Strava ha risposto recuperando realmente le mie attività recenti, riconoscendo tra queste i miei allenamenti di nuoto.

A quel punto il progetto ha cambiato natura:  Planned + Completed.

AI-nuoto dispone di due prospettive differenti.

Da una parte: Final Surge → cosa era previsto

Dall’altra: Garmin → Strava → cosa è realmente successo

E in mezzo: Profilo atleta → chi sta facendo quegli allenamenti

L’AI può quindi iniziare a ragionare su qualcosa di molto più interessante:

Previsto → Eseguito → Differenza → Decisione successiva

L’architettura concettuale è diventata:

Final Surge → Planned
↓
Knowledge Base

Garmin → Garmin Connect → Strava API → Completed
↓
AI-nuoto

Profilo atleta → Context
↓
Analisi → prossimo allenamento

Ed è qui che, secondo me, l’AI applicata allo sport comincia davvero a diventare interessante dato che l’obiettivo del progetto non è costruire una macchina che dica: “Oggi fai 10×100 A2 recupero 15 secondi” (un normale LLM può già generare qualcosa del genere in pochi secondi).

Quello che sto cercando di costruire è un sistema capace di rispondere prima ad altre domande:

  1. Cosa ho fatto nelle ultime settimane?
  2. Cosa era previsto?
  3. Cosa ho realmente completato?
  4. Qual è stata la progressione?
  5. Quali stimoli ho già ricevuto?
  6. Qual è il mio obiettivo attuale?

E soltanto dopo:

  • Cosa avrebbe senso fare adesso?

È una differenza sostanziale.

L’AI non diventa interessante quando genera più velocemente una scheda.

Diventa interessante quando dispone del contesto necessario per prendere una decisione migliore.

Il vero progetto è trasformare dati in contesto

Alla fine dei miei primi due giorni di ferie mi sono reso conto che AI-nuoto è in realtà un piccolo laboratorio su qualcosa di molto più grande.

Abbiamo già moltissimi dati personali e professionali distribuiti in applicazioni differenti, il problema è che ogni componente conosce soltanto un pezzo della storia.

L’AI può diventare lo strato capace di collegare questi pezzi

Nel mio piccolo esperimento:

  • Final Surge conosce il programma.
  • Garmin conosce il gesto eseguito.
  • Strava rende accessibile l’attività.
  • La Knowledge conserva la storia.
  • Il profilo fornisce il contesto.
  • L’AI mette tutto in relazione.

La sequenza che mi interessa è quindi:

DATA → KNOWLEDGE → CONTEXT → DECISION

E probabilmente è questo l’aspetto che continuerò a esplorare.

Perché, da nerd appassionato di tecnologia e di lunghe nuotate in acque libere, c’è qualcosa di particolarmente affascinante nell’idea che anni di vasche, chilometri, test, gare e allenamenti non rimangano semplicemente righe archiviate dentro qualche applicazione.

Possono diventare memoria utilizzabile.

E una memoria utilizzabile può diventare contesto e il contesto diventa analisi.

E l’analisi, può aiutarmi a fare una cosa molto semplice:

Nuotare meglio e più veloce!


Nei prossimi articoli: Garmin, Strava e AI: come trasformare i dati reali dell’allenamento in informazioni utilizzabili da un agente AI.

Qui entreremo più nel tecnico: API, OAuth, GPT Actions, Planned vs Completed e architettura dell’integrazione, senza perdere di vista la domanda fondamentale: quali dati servono davvero a un’AI per capire come ci stiamo allenando?

Dal diario di allenamento a un coach AI personale

Sottotitolo: Come trasformare anni di allenamenti, dati e passione per il nuoto in un agente AI capace di conoscere la mia storia sportiva

I primi due giorni di ferie, normalmente, dovrebbero servire a staccare.

Nel mio caso è successo più o meno il contrario.

Da buon nerd, appassionato di tecnologia e grande cultore del nuoto in acque libere, mi sono posto una domanda che, come spesso accade, sembrava innocua:

“E se mi costruissi un agente AI che conosce davvero il mio modo di allenarmi?”

Non un chatbot al quale chiedere genericamente “fammi un allenamento di nuoto da 3.000 metri”. Quello è relativamente semplice.

Volevo qualcosa di diverso.

  1. Un agente che conoscesse anni di allenamenti, sapesse come sono strutturate le mie Sedute A e B, riconoscesse A1, A2, B1, B2, C1, pull, pinne, boccaglio, remate e lavori di sensibilità.
  2. Un sistema che conoscesse i miei riferimenti prestativi, sapesse distinguere ciò che avrei dovuto fare da ciò che ho realmente fatto e, soprattutto, utilizzasse tutto questo contesto prima di suggerirmi cosa fare dopo.

Così sono iniziati i miei primi due giorni di ferie.

E naturalmente sono finiti con Final Surge, Garmin, Strava, API, OAuth, Knowledge Base e un agente AI.

Forse la definizione di ferie per un nerd è leggermente diversa.

Il problema non sono i dati. È riuscire a usarli !

Come molti sportivi che utilizzano tecnologia durante gli allenamenti, negli anni ho accumulato una quantità notevole di informazioni.

  • Gli allenamenti programmati sono in Final Surge.
  • L’orologio Garmin registra ciò che faccio realmente.
  • Garmin Connect raccoglie le attività. Strava ne riceve una copia.

Il risultato è che possiedo moltissimi dati, ma possedere dati non significa necessariamente possedere conoscenza.

Se voglio sapere cosa ho fatto ieri, è semplice.

Se invece voglio rispondere a domande come:

  • Come sono cambiate le mie Sedute A negli ultimi sei mesi?
  • Quali esercizi tecnici ho utilizzato maggiormente?
  • Quanto lavoro A2 sto facendo?
  • L’allenamento che dovrei fare domani è coerente con le ultime settimane?

la situazione cambia!

I dati ci sono, ma sono distribuiti in sistemi diversi e soprattutto manca qualcosa che li metta in relazione.

Ed è qui che l’AI diventa interessante.

Primo passo: Dare una memoria al coach

La prima operazione è stata recuperare lo storico da Final Surge.

L’obiettivo non era semplicemente esportare dei PDF e caricarli dentro un GPT. Volevo trasformare quello storico in una Knowledge Base utilizzabile dall’agente.

Ho quindi estratto esclusivamente gli allenamenti di nuoto, identificati dalle mie classiche voci Seduta A, Seduta B, ecc., eliminando tutto ciò che non era pertinente.

Il risultato è stato un archivio strutturato di 221 allenamenti, dal quale l’AI può recuperare una determinata seduta, confrontare periodi differenti e riconoscere progressioni ed elementi ricorrenti.

Questo cambia radicalmente il tipo di domanda che posso fare.

Non più: “Creami un allenamento da 3.000 metri.”

Ma: “Analizza le ultime tre Sedute A e proponimi la successiva, mantenendo una progressione coerente.”

Sono due richieste apparentemente simili, ma concettualmente molto diverse.

Nel primo caso l’AI genera, nel secondo deve prima recuperare, comprendere e contestualizzare.

Ma, una Knowledge Base non basta

A quel punto è emerso un secondo problema.

L’agente conosceva gli allenamenti, ma non conosceva abbastanza bene l’atleta.

Ho quindi creato un secondo elemento: il Profilo Atleta.

Qui sono raccolti i riferimenti utili per interpretare lo storico:

Età, disciplina prevalente, frequenza degli allenamenti, piscina e acque libere, obiettivi e alcuni riferimenti prestativi.

Per esempio:

200 m → 3:45
400 m → 7:42
1.000 m → 19:22
CSS storico → circa 1:58/100 m

Con una regola fondamentale: un dato storico non deve essere considerato automaticamente un dato attuale.

Se domani effettuo un nuovo test, il sistema deve utilizzare il nuovo valore senza perdere quello precedente, perché proprio il confronto nel tempo permette di capire l’evoluzione.

A questo punto iniziava a delinearsi una struttura interessante:

  • Knowledge → cosa ho fatto nel tempo
  • Profilo → chi sono e quali sono i miei riferimenti
  • Conversazione → qual è la mia situazione oggi

Poi arriva il problema dei 3.000 metri.

Chi prepara allenamenti di nuoto probabilmente sorriderà.

Chiedere a un’AI: “Preparami una seduta esattamente da 3.000 metri”, può produrre una bellissima scheda che termina con:

TOTALE: 3.000 m

Peccato che, facendo i conti, magari siano 2.850.

Un piccolo dettaglio: quando sei in acqua e scopri che il totale scritto in fondo alla scheda è più ottimista della matematica.

Per questo nelle Instructions di AI-nuoto ho inserito una regola quasi ossessiva:

il totale non si dichiara, si calcola.

Ogni blocco deve essere calcolato, le moltiplicazioni delle serie devono essere considerate e alla fine tutto deve essere sommato nuovamente.

Durante il collaudo ho quindi chiesto all’agente di analizzare le ultime tre Sedute A e crearne una nuova esattamente da 3.000 metri.

Il risultato finale è stato:

Riscaldamento: 600 m
Esercizi: 400 m
Attivazione: 400 m
Lavoro: 1.200 m
Defaticamento: 400 m

Totale:

3.000 m.

Questa volta anche secondo la matematica.

Può sembrare una banalità, ma è un esempio molto concreto di un principio importante quando costruiamo sistemi AI: non basta fornire informazioni al modello. Dobbiamo anche definire le regole con cui deve utilizzarle.

Ma….  mancava ancora metà della storia.

Nel prossimo articolo vedremo cosa serve

Come raggiungere Il Ronco senza perdersi – Garlate

Molti ospiti utilizzano Google Maps per raggiungere il Ronco.

Purtroppo, in tutti i casi il navigatore conduce erroneamente in Via Valcavellino a Garlate, una strada che non porta all’Agriturismo Il Ronco e che può creare confusione.

Per evitare inutili perdite di tempo, vi consigliamo di seguire queste semplici indicazioni.

Dove parcheggiare

Il Ronco è immerso nella natura e non è raggiungibile direttamente in auto.

Una volta arrivati a Garlate, lasciate la vostra vettura in uno dei parcheggi pubblici del centro paese puntando sul navigatore Piazza Vittorio Veneto.

Dai parcheggi potrete:

  1. Chiamare la navetta del Ronco, che verrà a prendervi direttamente in paese.
  2. Raggiungere l’agriturismo a piedi con una piacevole passeggiata di circa 10 minuti attraverso il caratteristico nucleo storico di Garlate, passando per via Francesco Crispi. (vedi Mappa in calce)

Buon appetito e buona vista sul bellissimo lago di Garlate!


Stella – Il mio cane

Oggi 26 Febbraio 2021 Stella ci ha lasciato.

Era qualche mese che stavi orgogliosamente lottando e noi con te.

Mi mancheranno i nostri “Buongiorno Stellina”, qualche carezza e poi subito a fare colazione, dove con i tuoi dolci occhi chiedevi un biscotto ben inzuppato nel Capuccino.

Poi mi seguivi fino all’auto come se dovessi essere il mio accompagnatore della giornata.

A fine giornata aprivo il cancello e tu eri li ad aspettarmi,  annussavi l’auto per determinare quali strade e persone avessi incontrato.

Ricordi di noi insieme ne ho tantissimi.

Da quello più tenero legato alle serate sdraiati sul divano a guardare dei film dove era impossibile arrivare alla scritta “The End”  perchè richiedevi quelle attenzioni che non avevi ricevuto di giorno.

A quello più gioioso dove correvi per il giardino e per campi alla ricerca di profumi nuovi anche se conoscevi perfettamente il territorio.

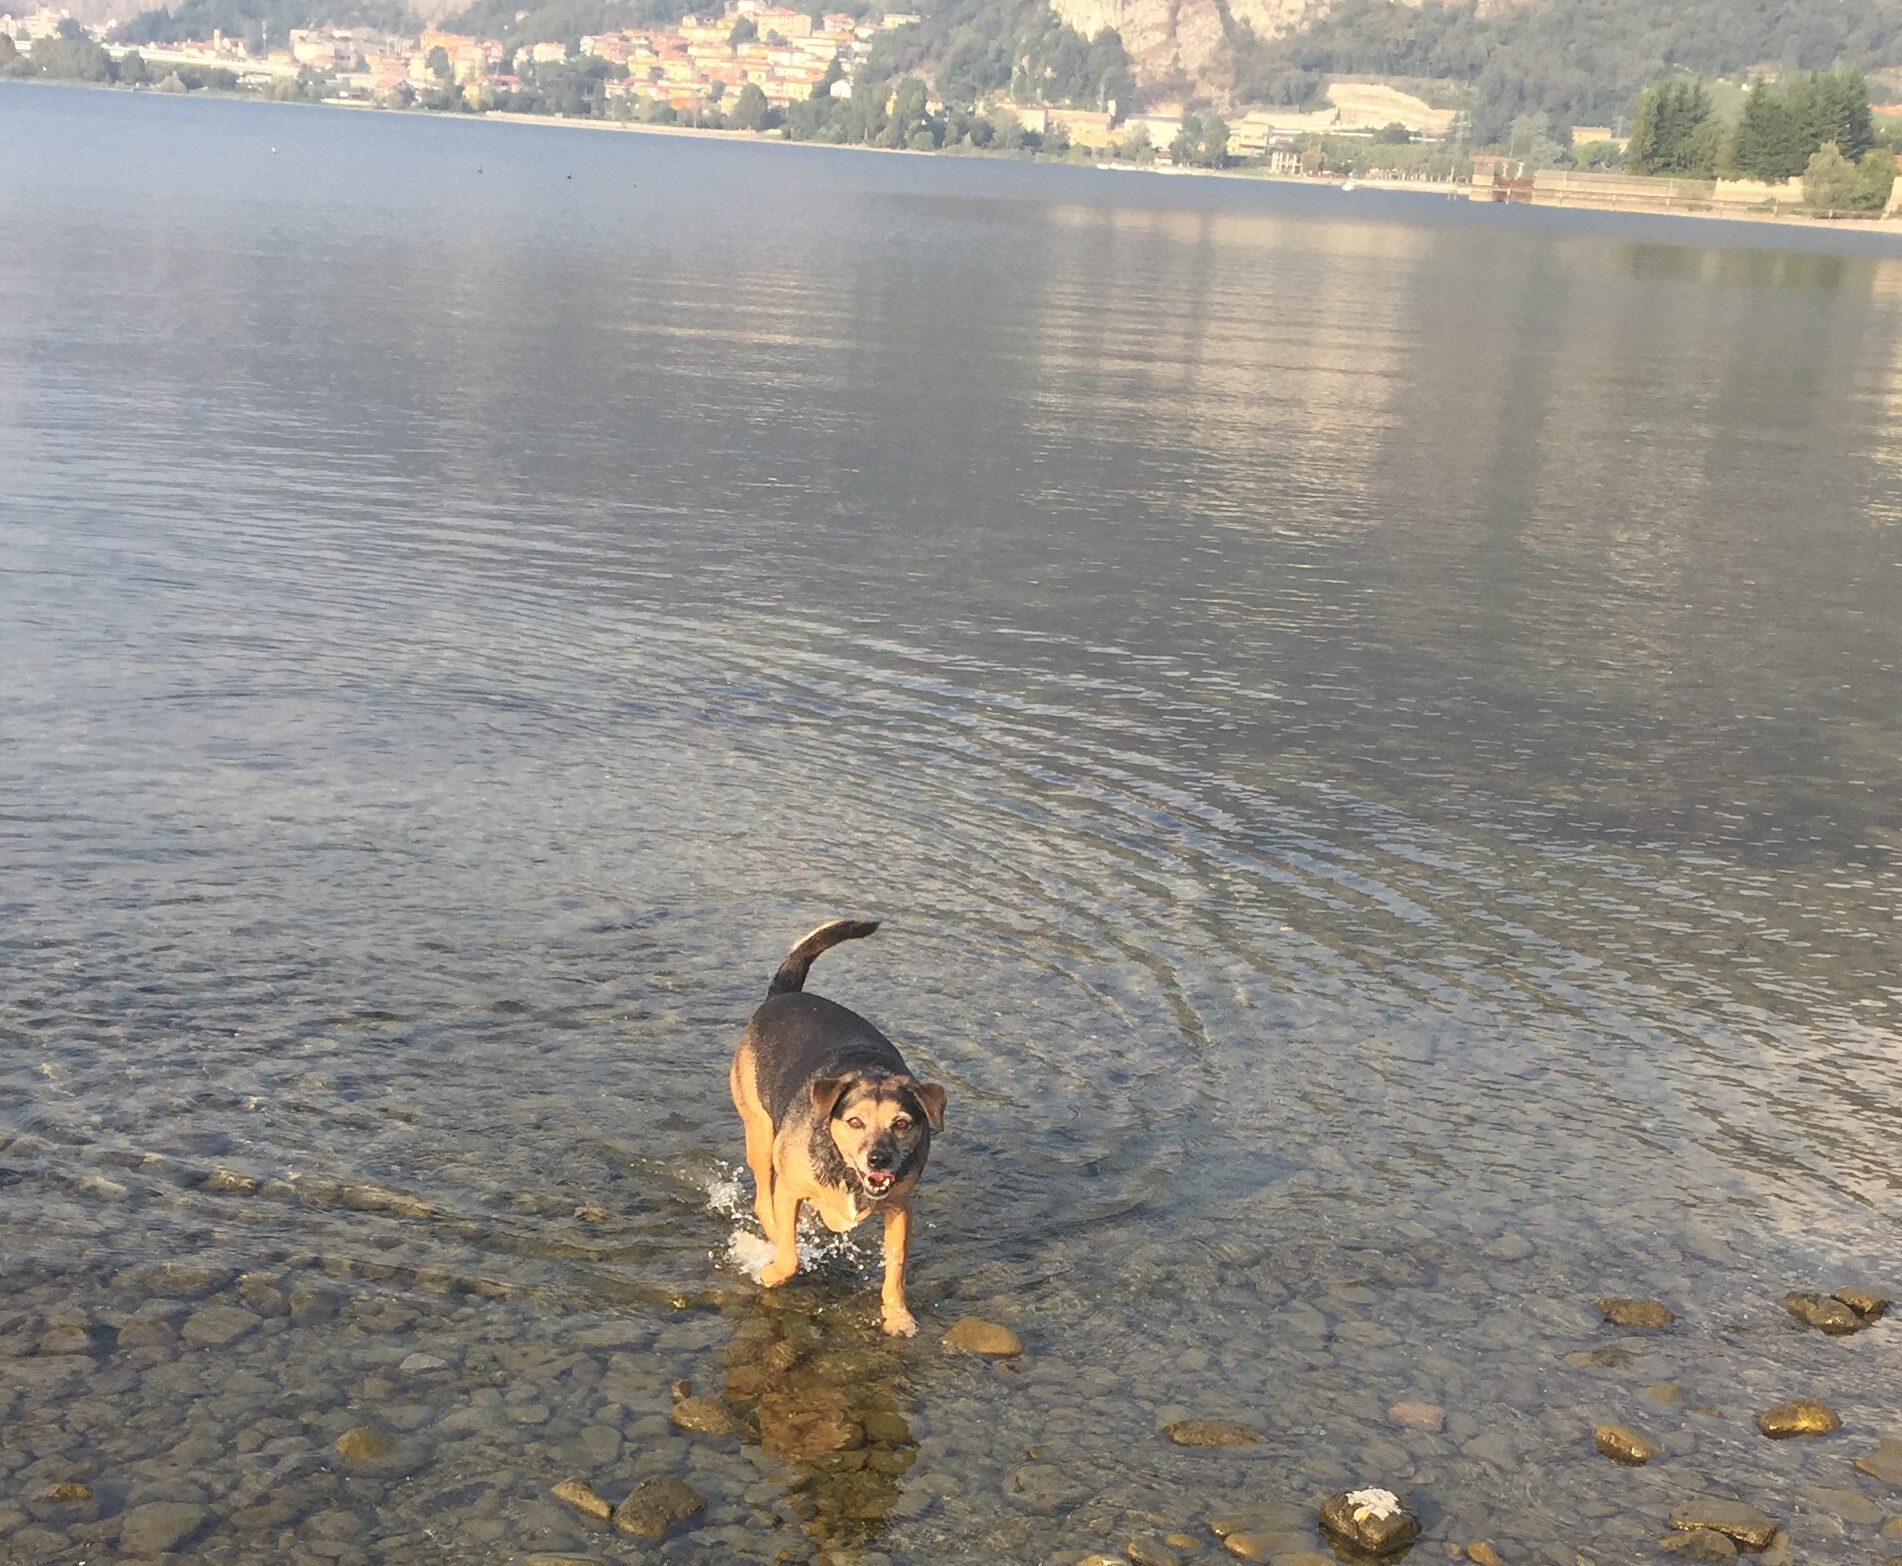
Oppure ancora quando ti buttavi nell’acqua del lago per rinfrescarti da una lunga corsa.

Tu riuscivi ad accendere le giornate uggiose per il clima e tristi per l’animo.

Grazie di essere stata il mio cane

Ciao Stellina

Site Restyling

In the next few days, the site will have some changes. The main reason is helping the internet surfer to find faster the article they want reading.

The First 5 improvements are:

1. The “who am I?” page has been included in the “all articles & about me” page
2. All the articles present on the site can be easily consulted from the “all articles & about me” page.
3. The backup menu name has been changed to Veeam.
4. The Veeam menu has three new categories. It allows identifying the technology scope
5. BBO bridge tournament results have been added to the bridge menu.


Nei prossimi giorni il sito subirà alcune modifiche. Lo scopo è quello di aiutare i frequentatori del sito a trovare più velocemente gli articoli che vogliono leggere.

I primi 5 miglioramenti sono:

1. La pagina “who am I?” è stata inserita nella  pagina “all articles & about me”
2. Tutti gli articoli presenti nel sito sono facilmente consultabili dalla pagina “all articles & about me“.
3. Il nome del menu backup viene modificato in Veeam.
4. Al menu Veeam sono state aggiunte 3 nuove sotto categorie per meglio individuare in quale ambito utilizzare le tecnologie.
5. Al menu del bridge sono stati aggiunti i risultati dei tornei di bridge BBO.