Configurazione dei NUC dopo l’installazione di Ubuntu

Scopo di questa fase

Una volta installato Ubuntu Server su ciascun Intel NUC, l’obiettivo non è ancora Kubernetes, ma creare una base stabile, sicura e coerente su cui costruire il cluster.

In questa fase si definisce il “DNA” dei nodi:

  • come si collegano in rete
  • come vengono amministrati
  • come vengono identificati
  • come possono essere automatizzati

Se questa base è solida, tutto il resto (Kubernetes, storage, backup) sarà affidabile.

Allineamento del sistema operativo

Ogni NUC deve partire dallo stesso stato logico in modo che reagiscano allo stesso modo in caso di problemi e che le performance non decadano se i workload vengono automaticamente spostati

  • Sistema aggiornato
  • Pacchetti base installati
  • Kernel e firmware allineati
  • Tool di rete, NFS, iSCSI e storage pronti
  • Questo garantisce che:

Identità dei nodi

Si configurano:

  • hostname univoci (nuc-01, nuc-02, nuc-03, nuc-mngt)
  • risoluzione DNS o /etc/hosts coerente

Questo è fondamentale perché Kubernetes non lavora con IP casuali, ma con identità logiche dei nodi.

Networking a più interfacce

Ogni NUC ha più schede di rete, con ruoli distinti:

Rete Scopo
Management SSH, API, controllo cluster
Storage iSCSI / NFS verso NAS
(opzionale) Frontend traffico applicativo

La separazione delle reti è una best practice enterprise per evitare che il traffico storage o backup rallenti k8s.

Configurazione firewall e sicurezza

  • porte aperte per Kubernetes
  • porte per SSH
  • porte per storage (iSCSI, NFS)
  • tutto il resto bloccato

Questo crea una superficie di attacco minima, fondamentale quando si parla di dati.

Abilitazione dell’accesso remoto sicuro

Tutti i nodi vengono resi amministrabili via SSH. permettendo :

  • gestione remota
  • automazione
  • troubleshooting
  • integrazione con strumenti di orchestrazione

È la base per poter gestire il cluster come una piattaforma, non come singole macchine.

Verifica delle interfacce di rete e dello storage

Prima di installare Kubernetes, si verifica che:

  • ogni nodo veda gli storage (Synology, WD)
  • le interfacce di rete siano attive
  • le rotte siano corrette
  • i NAS rispondano

In questa fase si valida un principio chiave:

k8s non può essere più affidabile dell’infrastruttura che lo sostiene.

Risultato

Alla fine di questa fase, i NUC non sono più “PC con Ubuntu”, ma diventano:

  • nodi di un’infrastruttura
  • pronti per lavorare insieme
  • collegati allo storage
  • gestibili in modo centralizzato

Questa è la fondazione fisica e logica su cui verrà costruito il cluster Kubernetes.
Da Bare-Metal a Kubernetes Cyber-Resiliente – Introduzione

Introduzione

Negli ambienti Kubernetes moderni, la vera sfida non è far girare i container, ma proteggere i dati.
Applicazioni, database e servizi stateful richiedono una piattaforma che garantisca:

  • Persistenza
  • Snapshot
  • Backup off-cluster
  • Ripristino affidabile

Questo progetto nasce con l’obiettivo di costruire, partendo da hardware fisico, una piattaforma Kubernetes pronta per ambienti enterprise, in grado di offrire resilienza dei dati e protezione da eventi critici come guasti o ransomware.

Obiettivo del progetto

L’obiettivo non era creare un semplice laboratorio, ma una piattaforma cloud-native completa, in cui:

  • Lo storage è condiviso e ridondato
  • I volumi sono gestiti da Kubernetes tramite CSI
  • I dati possono essere snapshot-tati
  • I backup sono esportati fuori dal cluster

In altre parole: Kubernetes diventa una piattaforma dati, non solo di calcolo.

Architettura di base

L’architettura si basa su tre elementi fondamentali:

  1. Nodi di calcolo (Intel NUC) per eseguire Kubernetes
  2. Storage esterno (Synology e WD) per ospitare i dati
  3. Rete dedicata per collegare compute e storage

Questo modello separa fisicamente calcolo, dati e gestione, una best practice delle architetture enterprise.

Abilitazione dello storage persistente

Lo storage esterno viene esposto a Kubernetes tramite:

  • iSCSI (Synology)
  • NFS (WD)

e integrato nel cluster attraverso CSI (Container Storage Interface).

Questo permette a Kubernetes di creare, montare e gestire volumi come risorse native.

Snapshot e consistenza dei dati

Sul CSI sono stati abilitati i componenti di snapshot, che consentono di:

  • Congelare lo stato di un volume
  • Proteggere database e file
  • Consentire backup applicativi consistenti

Questa è la base di qualsiasi strategia di data protection moderna.

Protezione dei workload con Kasten K10

Sopra Kubernetes è stato installato Kasten K10, la piattaforma di data management per Kubernetes, che fornisce:

  • Policy di backup
  • Snapshot orchestrati
  • Esportazione su storage esterno
  • Restore applicativo

Grazie a Kasten, i workload non sono più solo container, ma entità protette.

Storage di backup off-cluster

Un NAS Wester Digital collegatovia NFS è stato configurato come destinazione di backup al fine di mantenere una copia dei dati fuori dal cluster, requisito essenziale per:

  • Disaster recovery
  • Protezione ransomware
  • Isolamento dei backup

Risultato finale

Il risultato è una piattaforma Kubernetes che:

  • Gestisce storage persistente
  • Supporta snapshot CSI
  • Effettua backup applicativi
  • Replica i dati su storage esterno

In pratica:

K8s pronto per ambienti di produzione e cyber-resilienza.

Kubernetes: Pods

Nei precedenti articoli, abbiamo visto che i container sono dei luoghi “astratti” dove girano le applicazioni sotto forma di immagini.

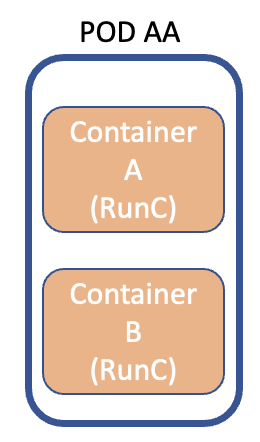
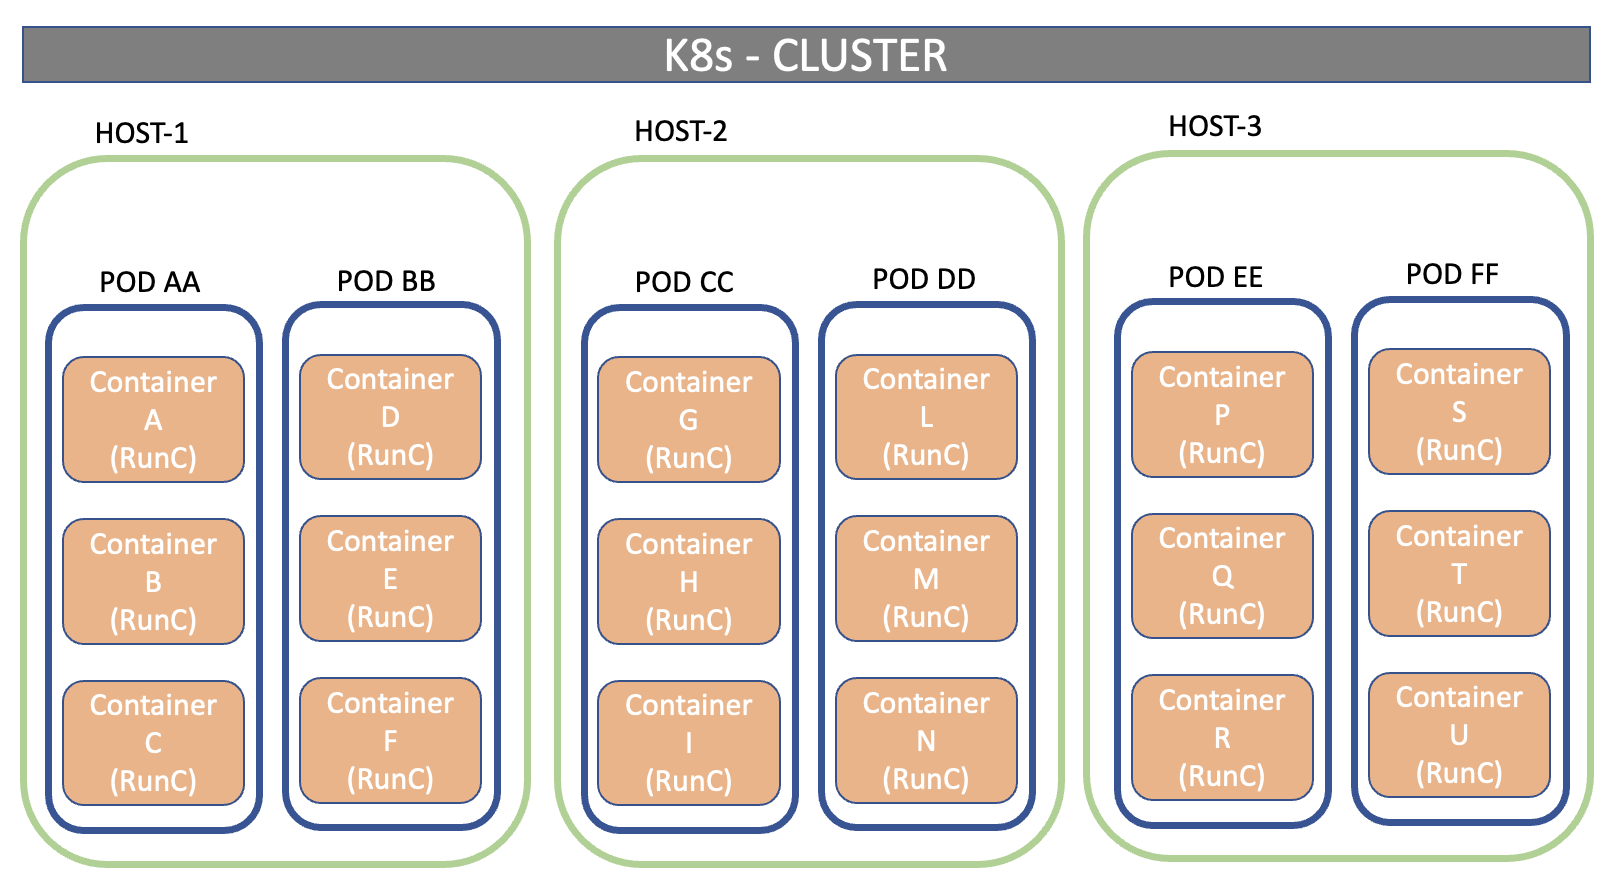
I POD sono l’aggregazione di più container.

Un servizio è l’aggragazione di più POD.

L’immagine di figura 1 mostra il concetto appena esposto.

Figura 1


Tutte le applicazioni (immagini) presenti all’interno dello stesso POD, avranno lo stesso indirizzo IP (condiviso) e lo stesso Hostname (UTS NameSpace).

La comunicazione tra i container all’interno dello stesso HOST avviene attraverso POSIX o le IPC di System V

Immaginate ora di voler erogare il servizio “the-gable-svc“, costruito con due immagini (container): un Database e un Front-End.

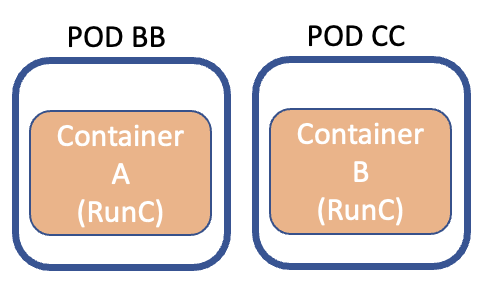
In fase di progetto è meglio disegnare un unico POD che contenga i due contanier (figura 2) oppure due POD con ognuno un container (figura 3)?  (1POD x 2 CONTAINER oppure 2 POD x 1 CONTAINER)

Figura 2

Figura 3

Per rispondere accuratamente è necessario comprendere quale applicazione ha la necessita di maggiore scalabilità e flessibilità.

Nel nostro esempio è il DB che per gestire picchi di accesso, potrebbe richiedere maggiori risorse (RAM & CPU).

Se avessi disegnato un unico POD, l’aumento delle risorse coinvolgerebbe entrambe le applicazioni, andando di fatto a non ottimizzare il dispendio energetico.

Nota 1: Le risorse CPU & RAM sono assegnate durante la creazione del POD.

E’ sempre meglio creare più POD?

Quest’ultima affermazione non è allineata con la politica di resilienza di K8s, dove  i POD dovrebbero girare su host fisici differenti (k8s è un cluster).

Per risolvere la dipartita, esista una buona regola:

Se il servizio funziona correttamente anche se i POD sono distribuiti su più host, allora è meglio utilizzare più POD (figura 2).

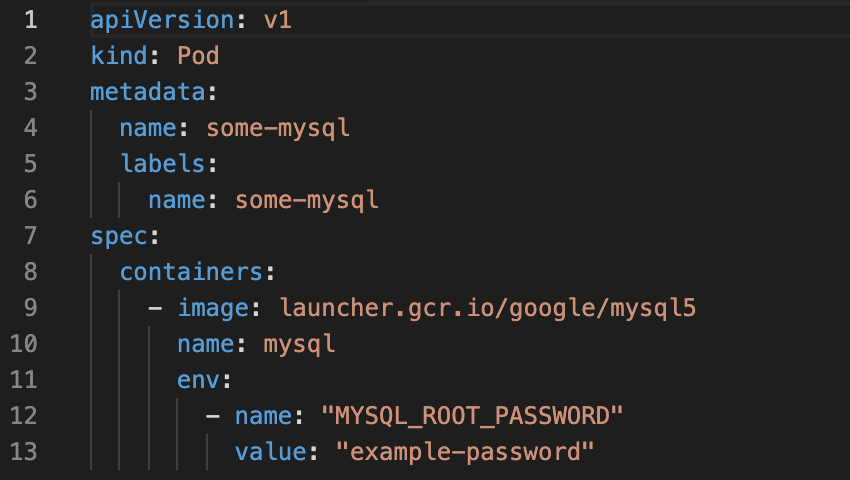
La Figura 4 mostra il contenuto del file mysql-pod.yaml che crea il POD per l’applicazione mySQL.

Figura 4

Vediamo la sintassi di base di gestione del POD:

  • Per avviarlo è sufficiente lanciare il comando: kubectl apply -f mysql-pod.yaml
  • Per verificarne lo stato: kubectl get pods
  • Per ottenere tutti i dettagli: kubectl describe pods some-mysql
  • Se volessimo cancellarlo: kubectl delete -f mysql-pod.yaml

Per oggi è tutto a tra poco dove parleremo di Accesso al POD, come copiare files e tanto altro ancora.

A presto